muxin / space
跳到主要内容

Selected work · 2025—2026

把想法做成
能被验证的系统。

这里放我最愿意在面试里展开讲的三个项目:从 Agent Harness,到 RAG 工程化,再到模型轻量化。重点不是堆技术名词,而是记录我如何拆问题、做实验、接受结果并继续迭代。

3个长期项目
AI应用与工程落地
从 0 到 1独立拆解与实现

Featured experience

2026.07 — 至今

AI 测试平台
工程化实习

在企业级 AI 测试平台中,负责从用例生成到真机执行反馈的工程闭环,重点解决“生成得快”与“跑得准”之间的落差。

查看实习案例 →

真机一次通过率

72.7% → 90.5%

用例有效率

34.9% → 78.6%

源码→文档校验→用例生成→真机执行→反馈校准
01 2026.02 — 至今

Aido

个人排期与规划智能体系统

项目负责人 · 核心 AI 后端开发

−82–89%

context token(三轮实验量化)

Agent HarnessFastAPIVue3PostgreSQL

一个面向个人用户的 AI 效能管理产品。它不只回答问题,而是把目标拆解、排期、执行反馈和偏好记忆串成一个可以持续工作的系统。
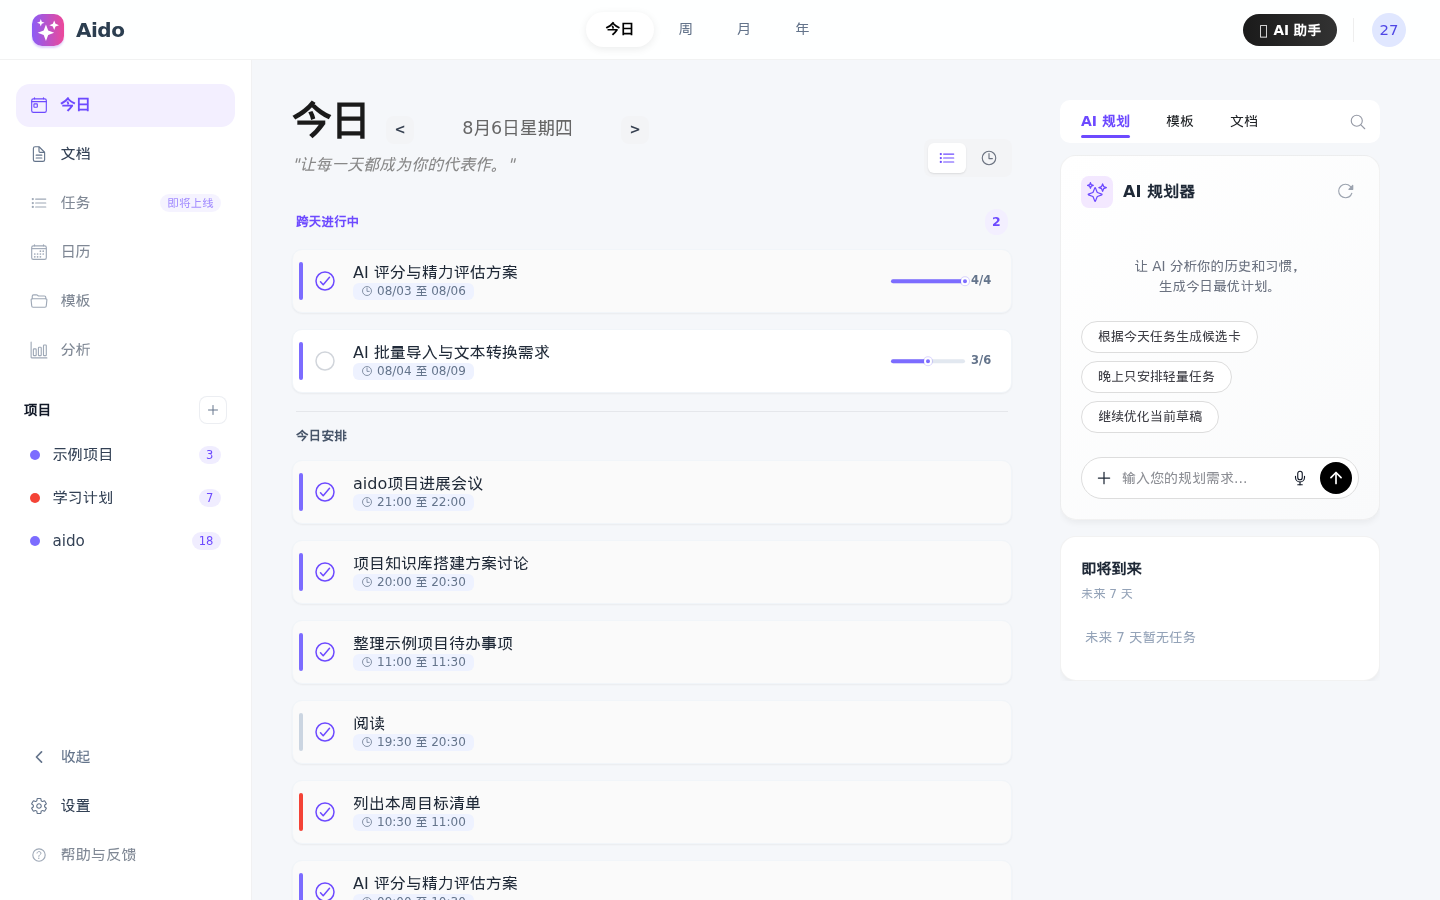
Aido 今日视图界面截图

What changed

把 Planner 从 LangGraph 迁移到自研 Harness,并用真实实验数据决定架构取舍。

  • 设计 AgentLoop、ToolRegistry 与 LoopBudget,覆盖循环控制、工具注册和预算熔断。
  • 搭建四层偏好记忆系统,让时长偏好、情绪反馈等信息能被静默提取并持续反刍。
  • 围绕按需提取与全量装配做三轮实验:context token 降低 82–89%,最终定位瓶颈是模型工具调用能力而非架构本身。
02 2026.03 — 至今

KeeperKit

TRPG 规则 RAG 助手

项目负责人 · 产品与全栈开发

1500+

行核心 RAG 代码(MVP → V1.2)

FastAPIChromaDBBGELangGraph

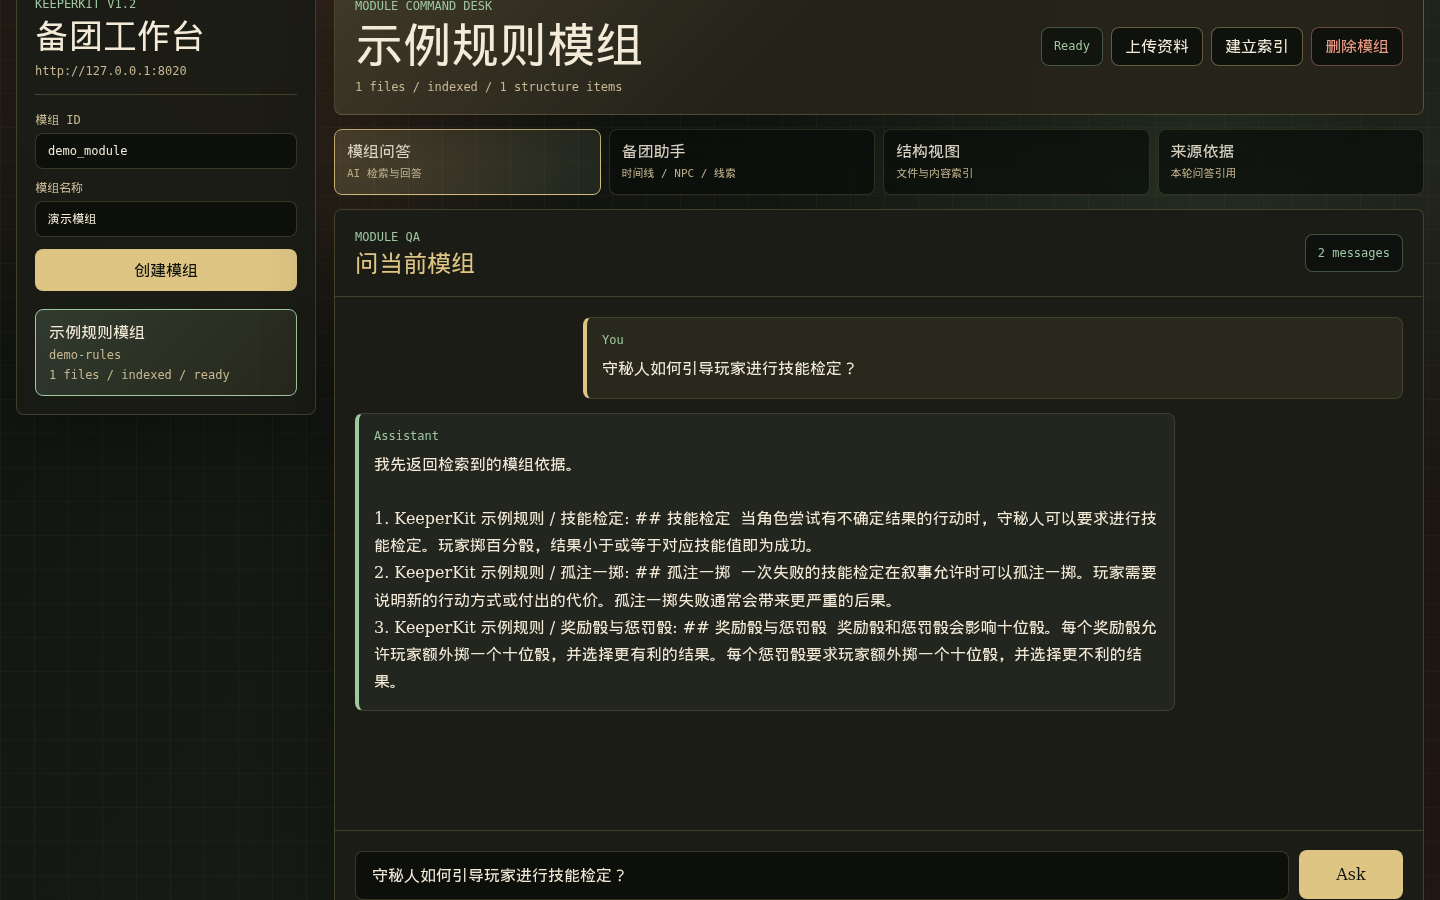
一个本地优先的 TRPG AI 工具箱,先从规则书问答切入,再逐步扩展到模组管理、时间线整理和 NPC / 线索摘要。

KeeperKit 规则问答界面截图

What changed

从零搭建可替换的 RAG 流水线,并把每一步实现沉淀成独立文档。

  • 完成文档加载、切块、向量化、检索、精排与生成的完整链路,持续迭代 MVP → V1.0 → V1.2。
  • 抽象 Embedding、VectorStore、Reranker 和 Generator 接口,支持组件自由替换升级。
  • 基于 LangGraph 搭建模组助手工作流,结合 PostgreSQL 会话记忆整理时间线并抽取 NPC / 线索摘要。
03 2025.10 — 2026.01

OPPO 小布助手

对话短文本语义匹配系统

项目负责人 · 算法开发

0.93

自测 AUC(对齐榜单最高分)

PyTorchRoBERTaSimCSEONNX

基于公开语音助手数据集完成的一次端侧语义匹配实训,重点探索模型轻量化、对比学习和推理效率之间的平衡。

What changed

在保持匹配效果的同时,将模型压缩到更适合低延迟推理的规模。

  • 处理 45 万条脱敏对话数据,完成数据清洗、训练、评估和端侧推理验证。
  • 将 12 层 BERT 压缩为 RoBERTa-4Layers,参数量降低 65%,推理速度提升约 3 倍。
  • 结合 SimCSE 对比学习与 FGM 对抗训练,自测 AUC 达到 0.93。

How I work

先把问题说清楚,再让系统跑起来。

我喜欢从可验证的小闭环开始:明确目标,拆出最小系统,记录关键指标,再根据真实结果决定继续放大、换方案,还是及时收窄。项目里的失败尝试同样值得留下,因为它们通常比最终的技术栈更能说明问题。